Appearance
HBase
Google 体系和 Hadoop 体系的对比
| 对比 | GFS | Bigtable | HDFS | HBase |
|---|---|---|---|---|
| 类型 | 分布式文件系统 | 分布式表存储 | 分布式文件系统 | 分布式 NoSQL 数据库 |
| 出身 | Apache Hadoop | Apache HBase | ||
| 对应开源实现 | HDFS | HBase | 本体 | 本体 |
| 存什么 | 大文件块 | 结构化/半结构化数据 | 大文件块 | 表数据 |
| 查什么 | 文件路径 | RowKey | 文件路径 | RowKey |
| 底层依赖 | 磁盘集群 | GFS | 磁盘集群 | HDFS |
| 典型节点 | Master / ChunkServer | Master / Tablet Server | NameNode / DataNode | HMaster / RegionServer |
| 适合 | 大文件存储 | 海量 KV/列族数据 | 大数据文件存储 | 海量随机读写 |
学习顺序:
先懂 HDFS NameNode、DataNode、Block、副本、读写流程
再懂 HBase RowKey、Column Family、Region、RegionServer、WAL、MemStore、HFile
再回看 GFS / Bigtable 论文 你会发现 Hadoop 生态很多东西就是 Google 论文落地版
- 四大概念:RowKey(字典序、Byte数组)、列族、稀疏、分布式存储/分片/Region/分区
HBase 数据模型
Namespace(库) -> Table -> Region -> Store -> StoreFile/HFile
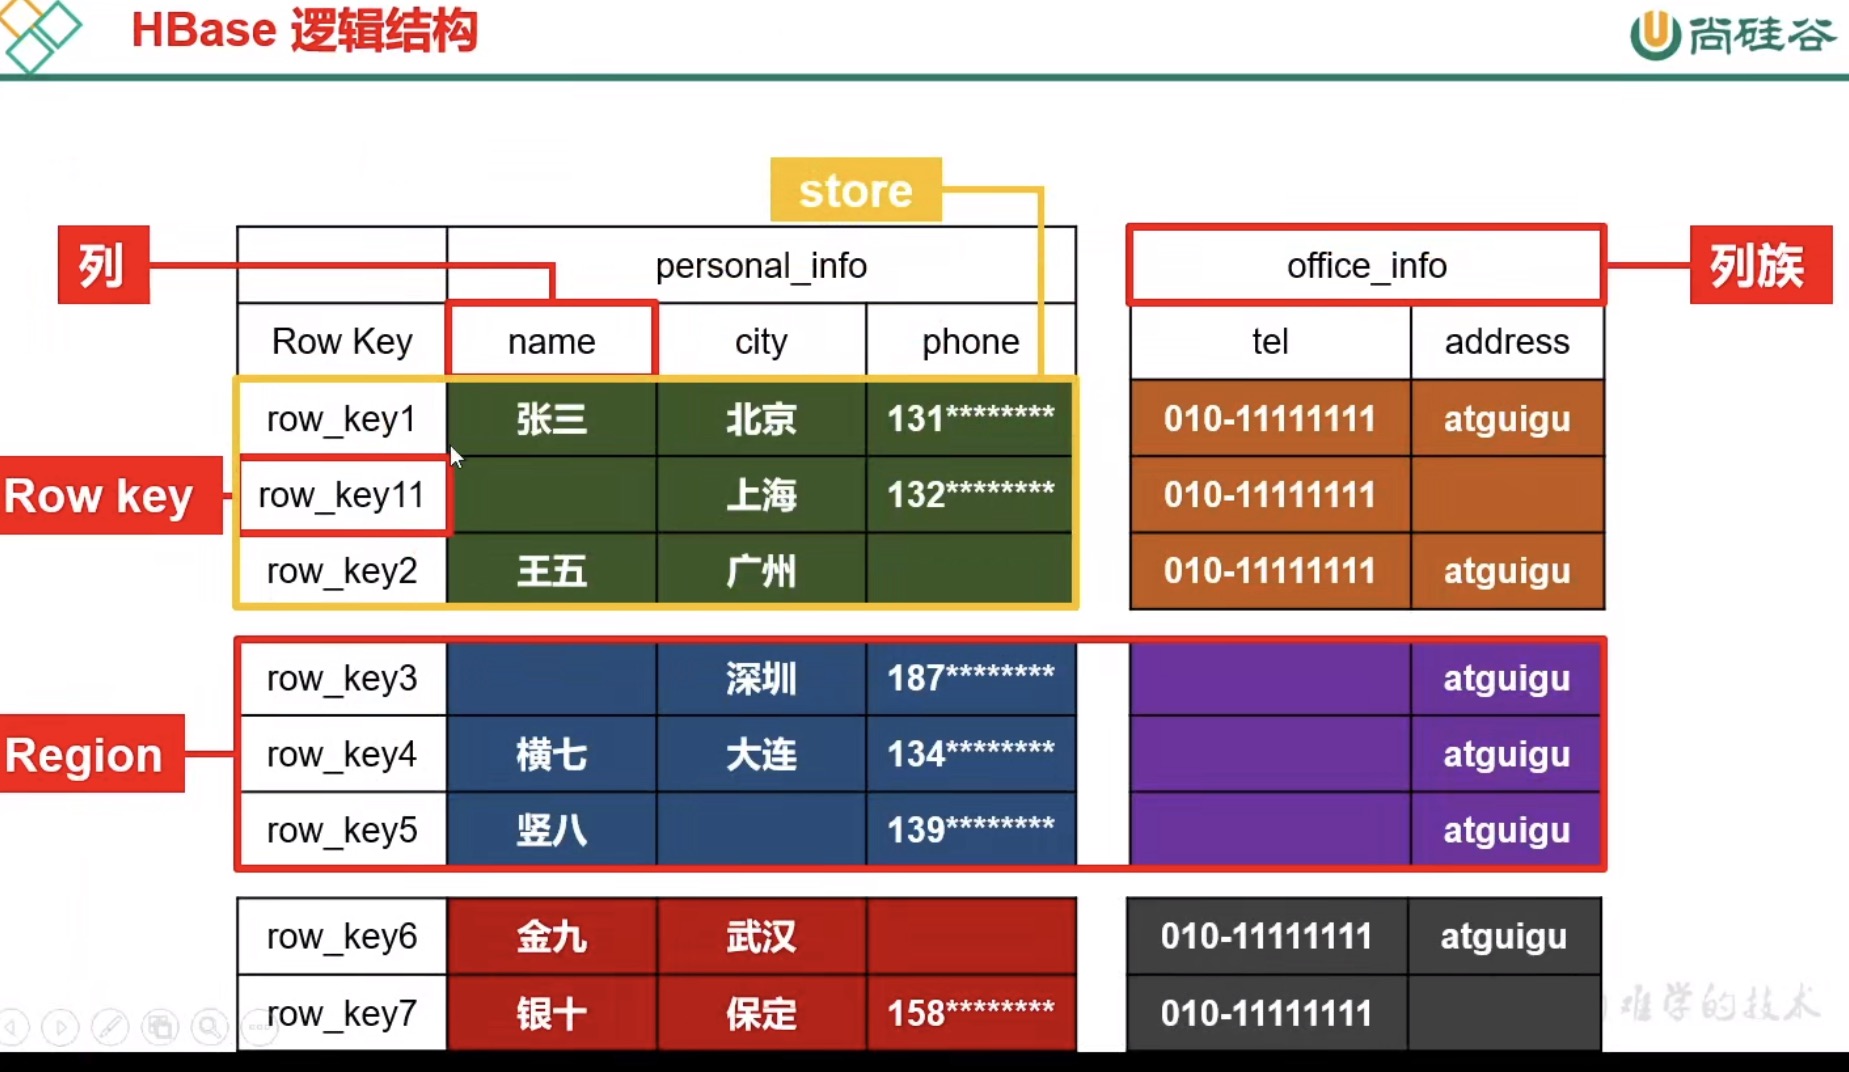
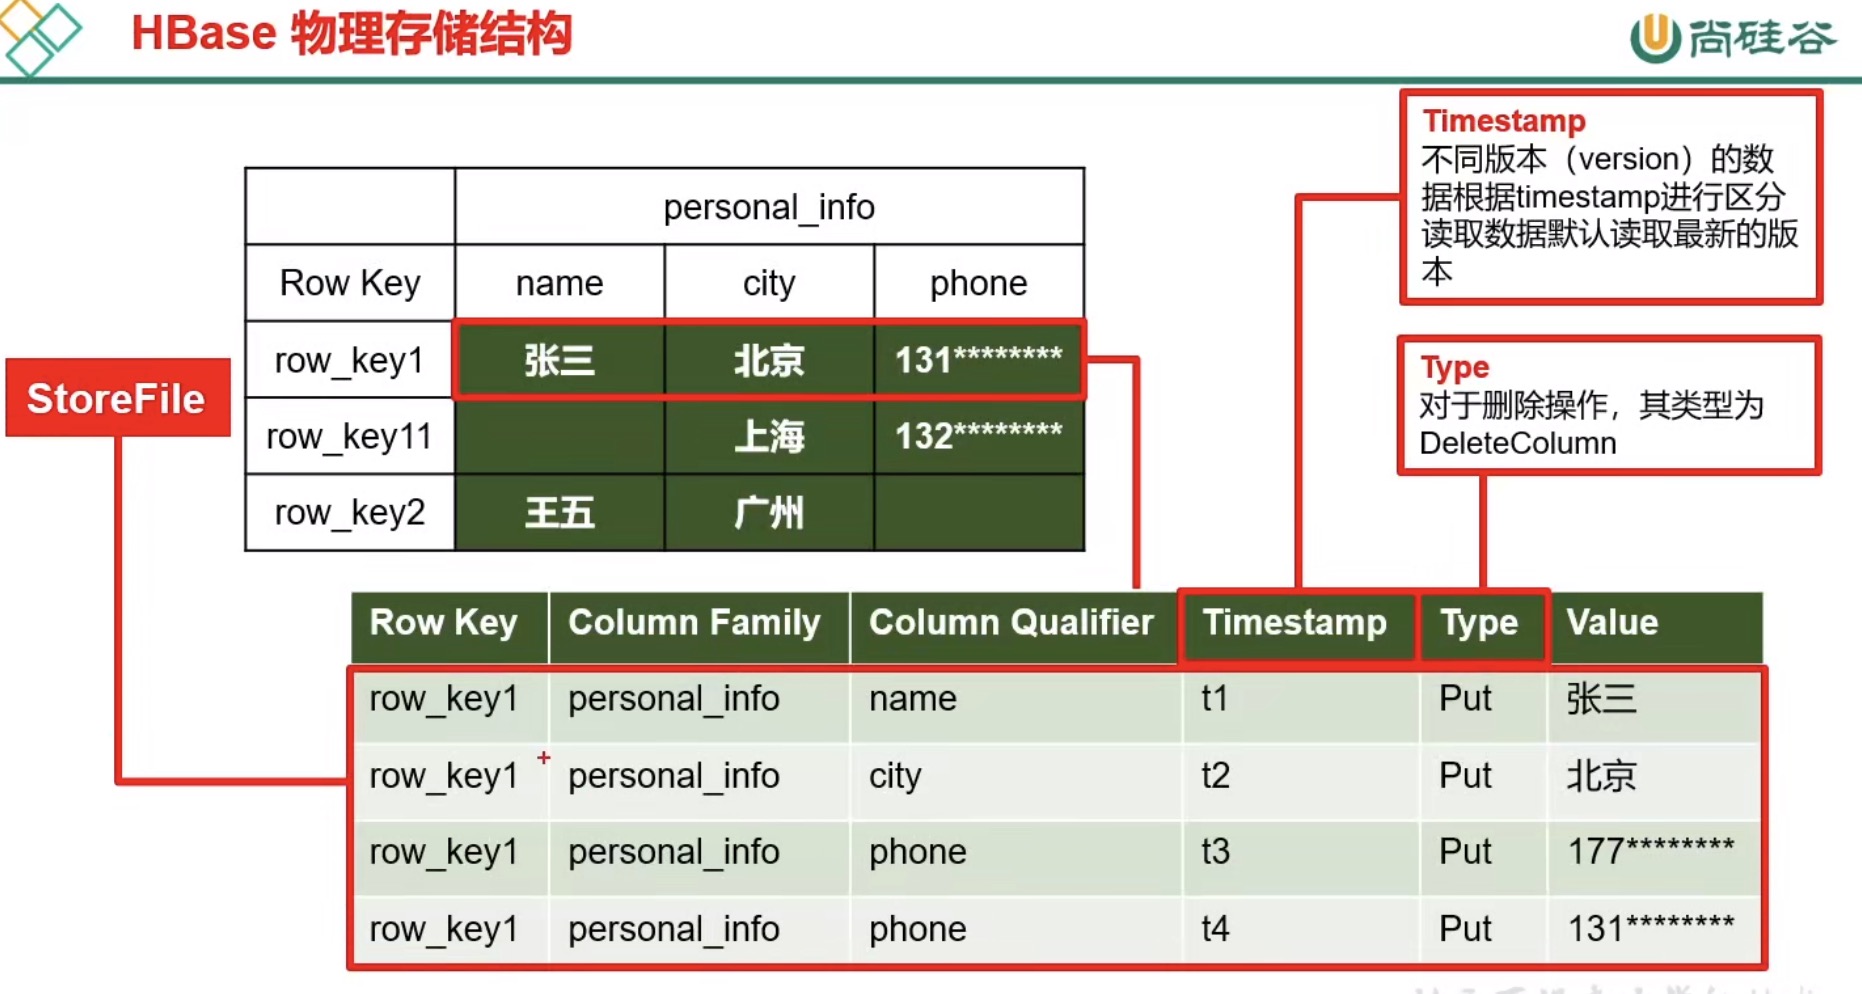
- HBase 的 HFile 由 KeyValue 构成,每个 KeyValue 就是一个 Cell,它通过 行键+列族+列名+时间戳 来唯一确定一个数据版本,Value 存值
HBase 架构
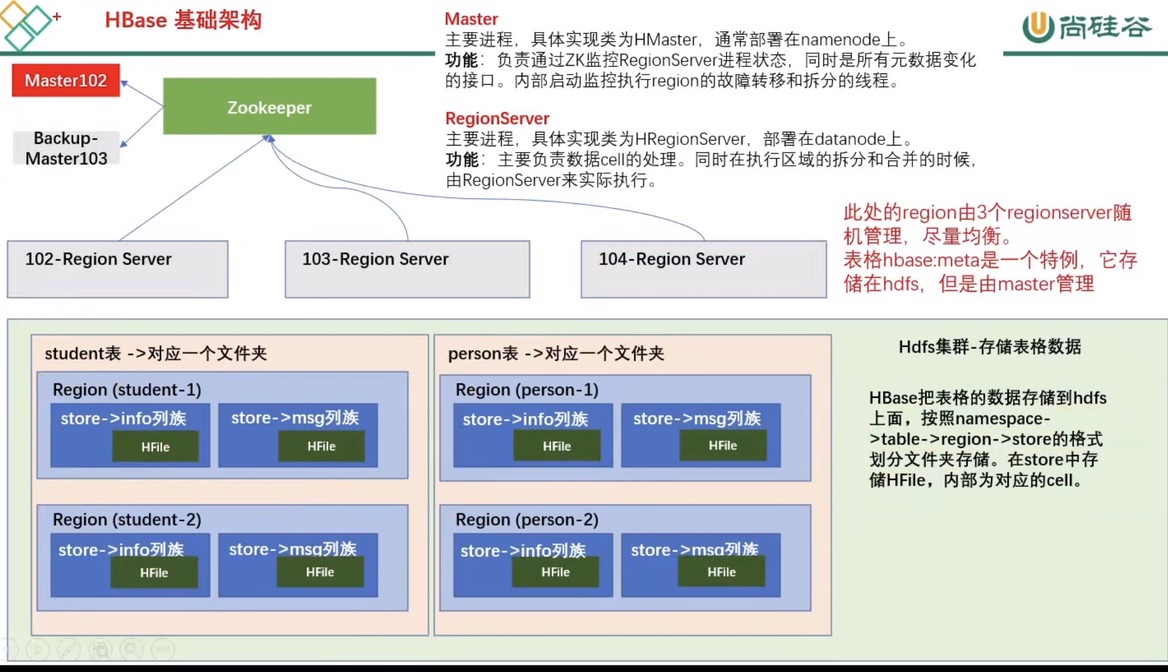
- RegionServer 主要负责数据的读写操作,而数据本身是持久化存储在 HDFS 上的(WAL日志)
- HBase 建议将 RegionServer 和 HDFS 的 DataNode 部署在同一台物理机器上
- Master 高可用 单点故障 主备模式
为什么 HBase 不采用“主从”来分担 Master 压力?因为 HBase Master 本身就不是性能瓶颈。如果让 Standby Master 也参与“读”请求,反而会引入复杂的分布式一致性问题(脑裂风险),得不偿失。
搭建实验环境
- 单机模式(Standalone Mode)数据存储在 HBase 进程所在的本地磁盘上
- 完全分布式模式(Fully-Distributed Mode)数据存储在 HDFS