Appearance
大数据系统
大数据技术栈科普
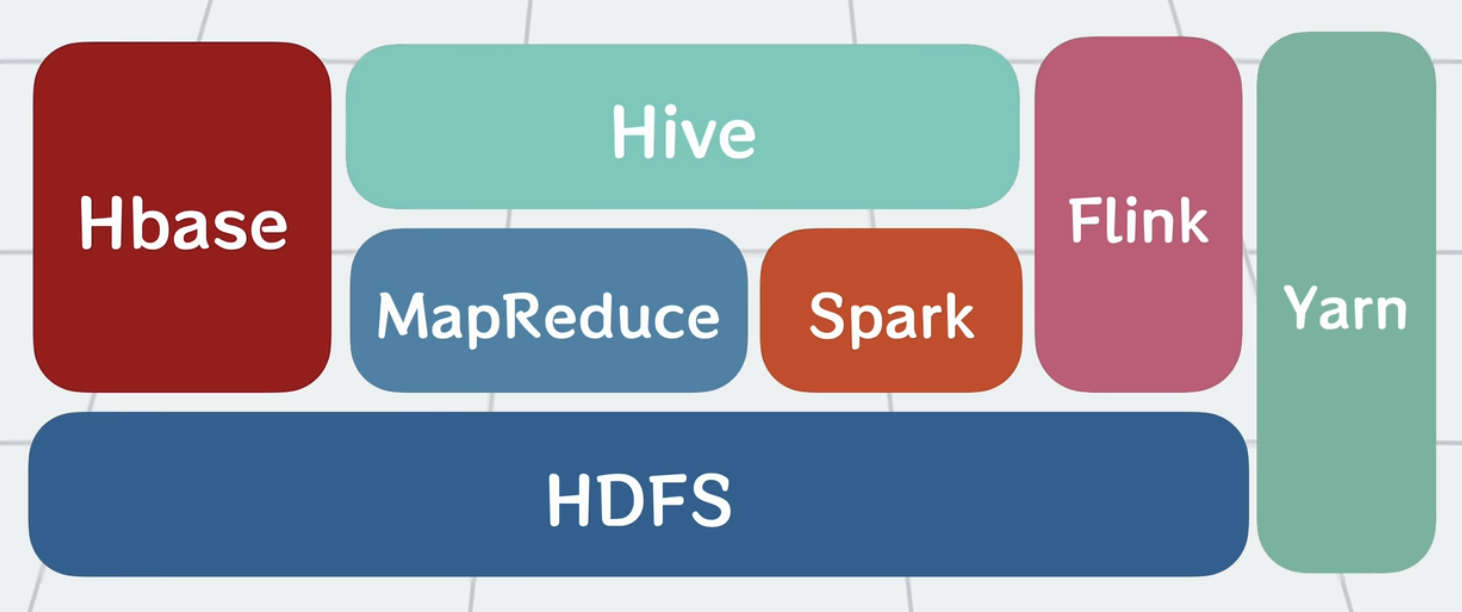
HDFS,Hadoop,MapReduce,Yarn,Spark,Flink,Spark SQL,Hive 这些都是啥玩儿
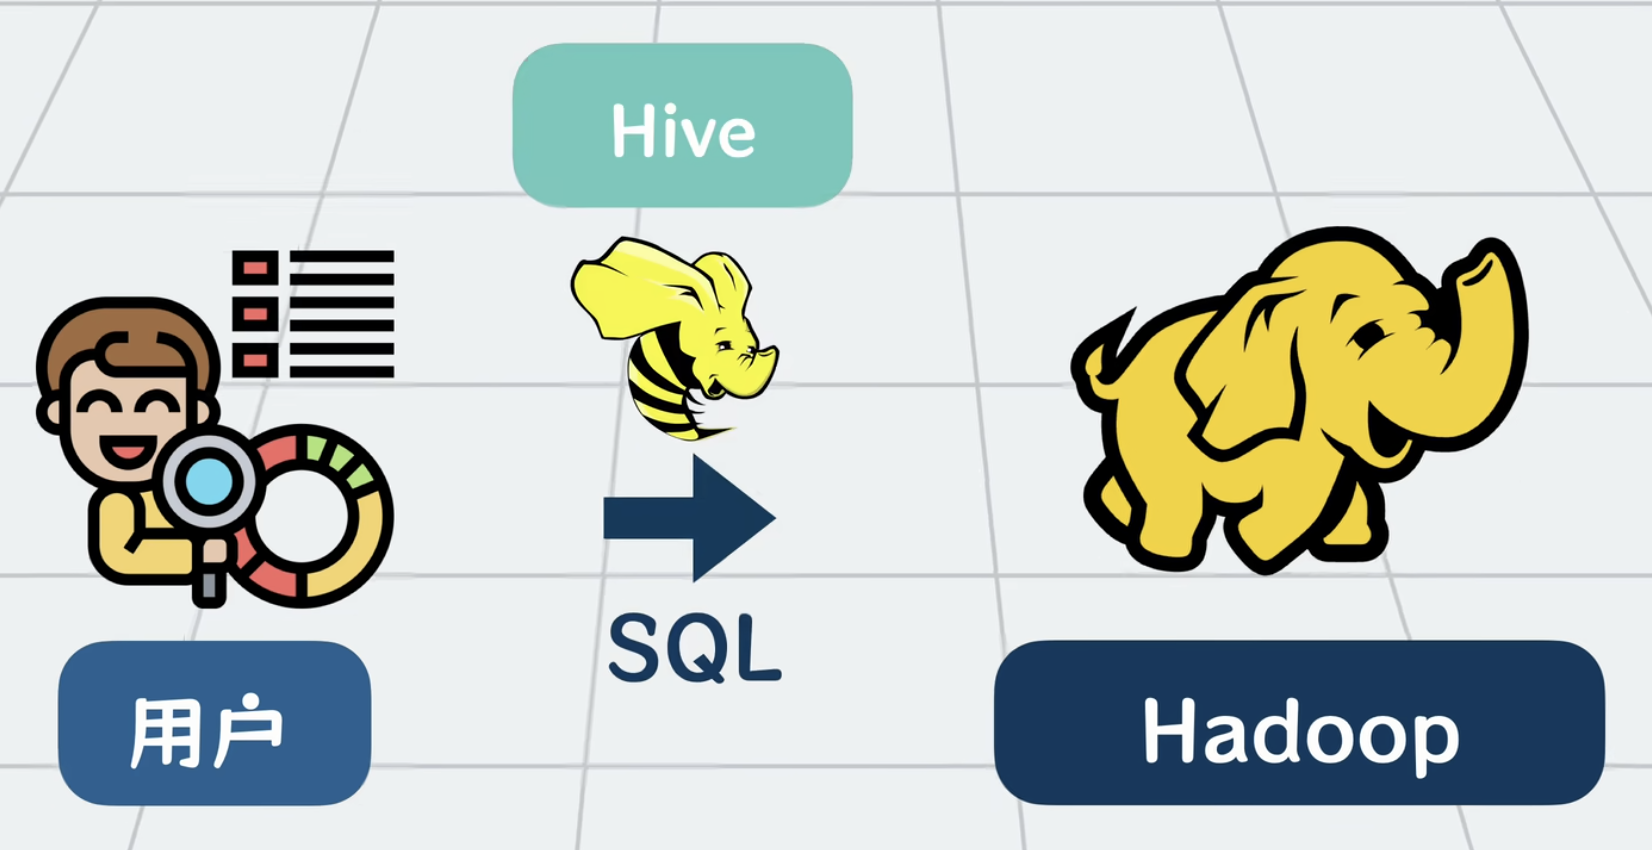
数据分析师只懂 SQL,不会 MapReduce 代码,因此 Hive 诞生了,这样不会写代码的人,也可以通过写 SQL 读写大数据
Hive SQL -> Hive -> MapReduce 将 SQL 解析为 MapReduce 任务
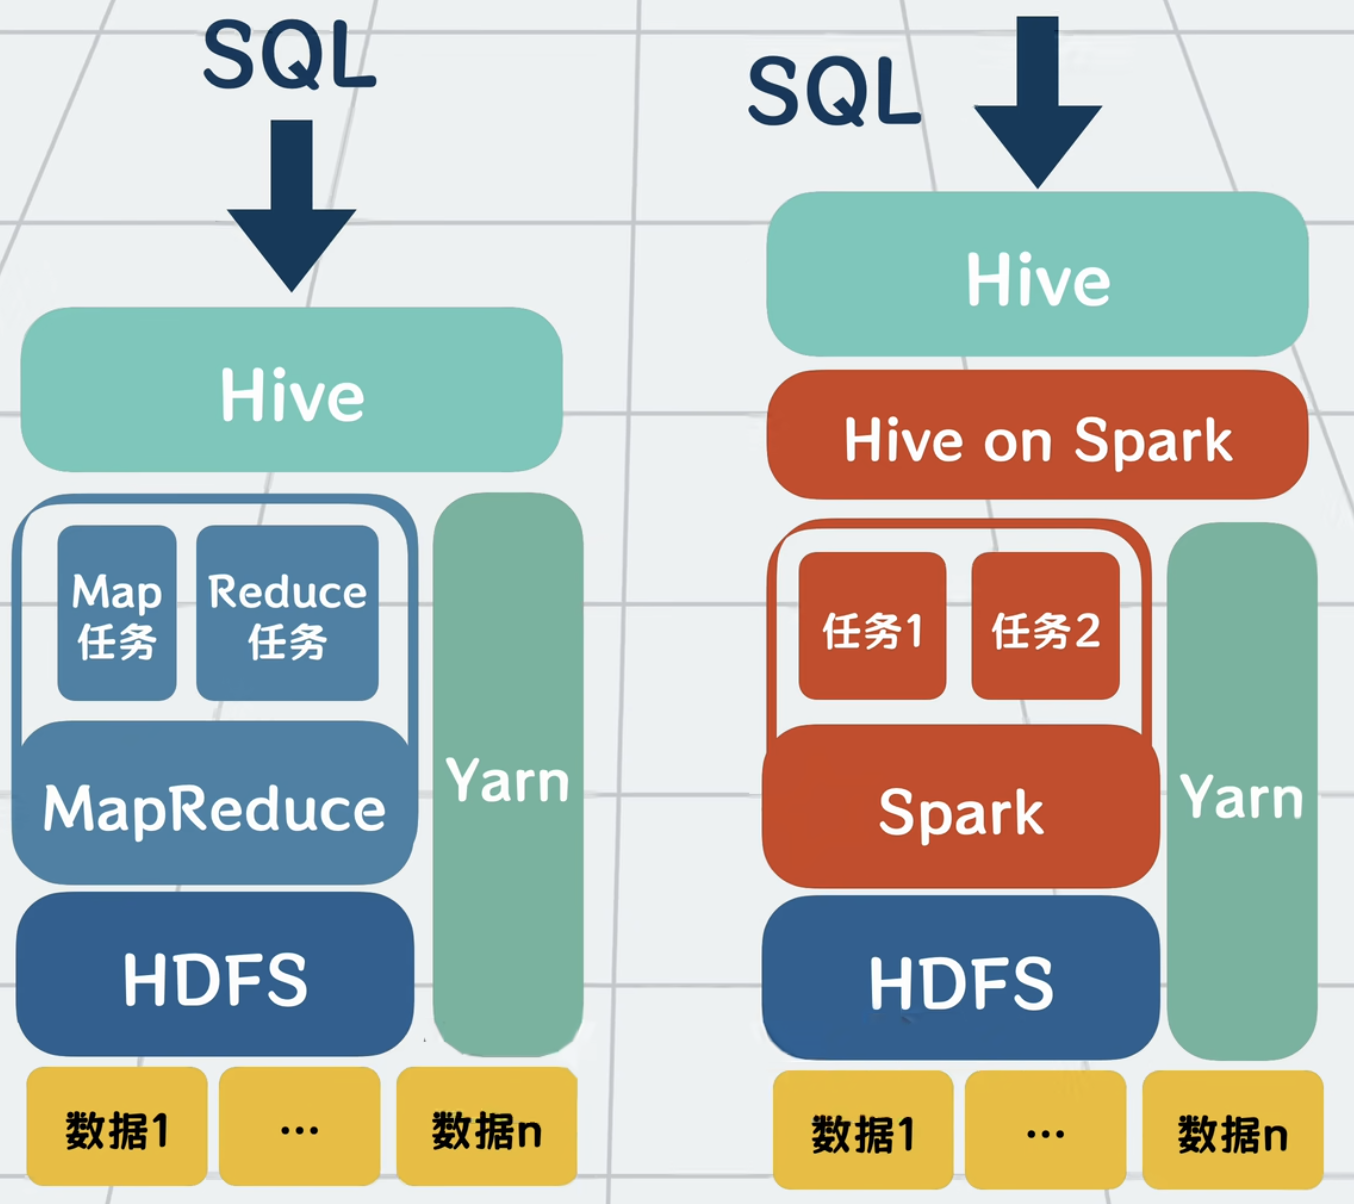
在 Hadoop 生态中,Hive 最初依赖 MapReduce 执行 SQL,频繁的磁盘落盘操作导致延迟高、效率低
为了解决这个问题,用 Spark 替换 MapReduce,核心原因有两点:
内存计算:Spark 将中间结果缓存在内存中,避免了 MapReduce 频繁的磁盘读写,性能可提升 10~100 倍;
DAG 执行引擎:Spark 将多个 Stage 组合成有向无环图,减少不必要的落盘和冗余计算,而 MapReduce 每个 Job 结束后必须写磁盘
因此 Hive on Spark 适配层应运而生,它将执行引擎由 MapReduce 替换为 Spark,但 SQL 解析仍由 Hive 负责,架构上存在一定冗余,未能充分发挥 Spark 的全部优势
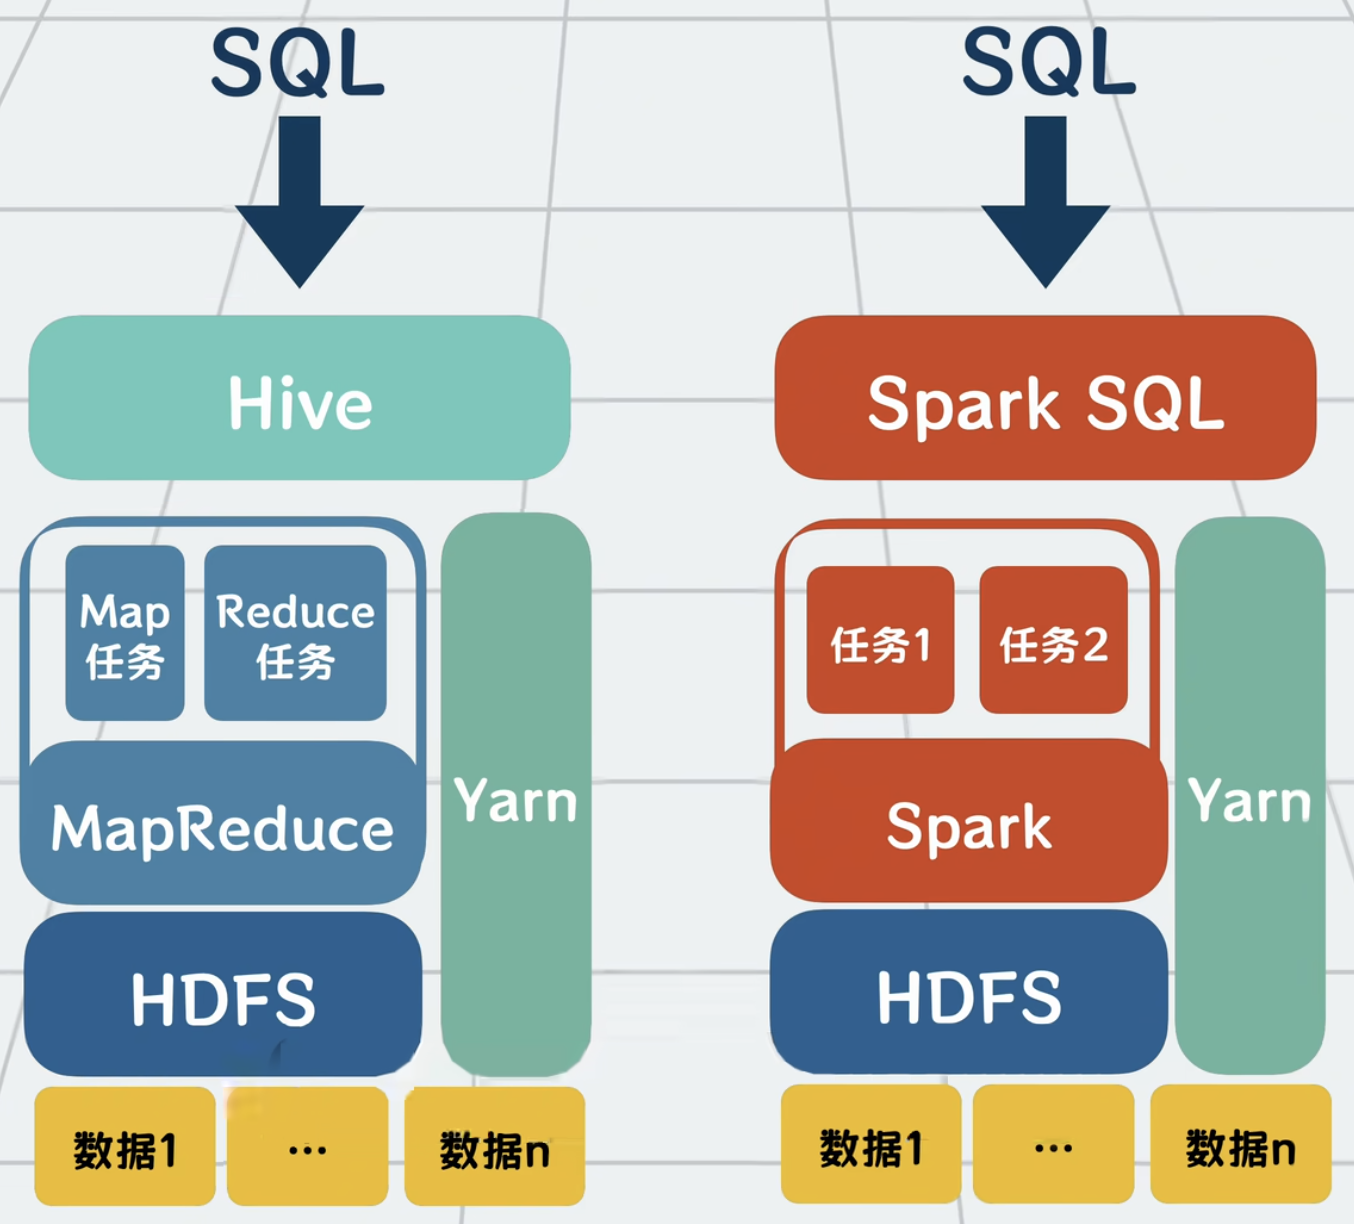
而 Spark SQL 出现后,Hive 的角色被简化为仅提供 Metastore,不再参与 SQL 解析
Spark SQL 虽与 Hive 同为 SQL 引擎,但作为 Spark 的原生实现,在性能上显著优于 Hive on Spark 模式
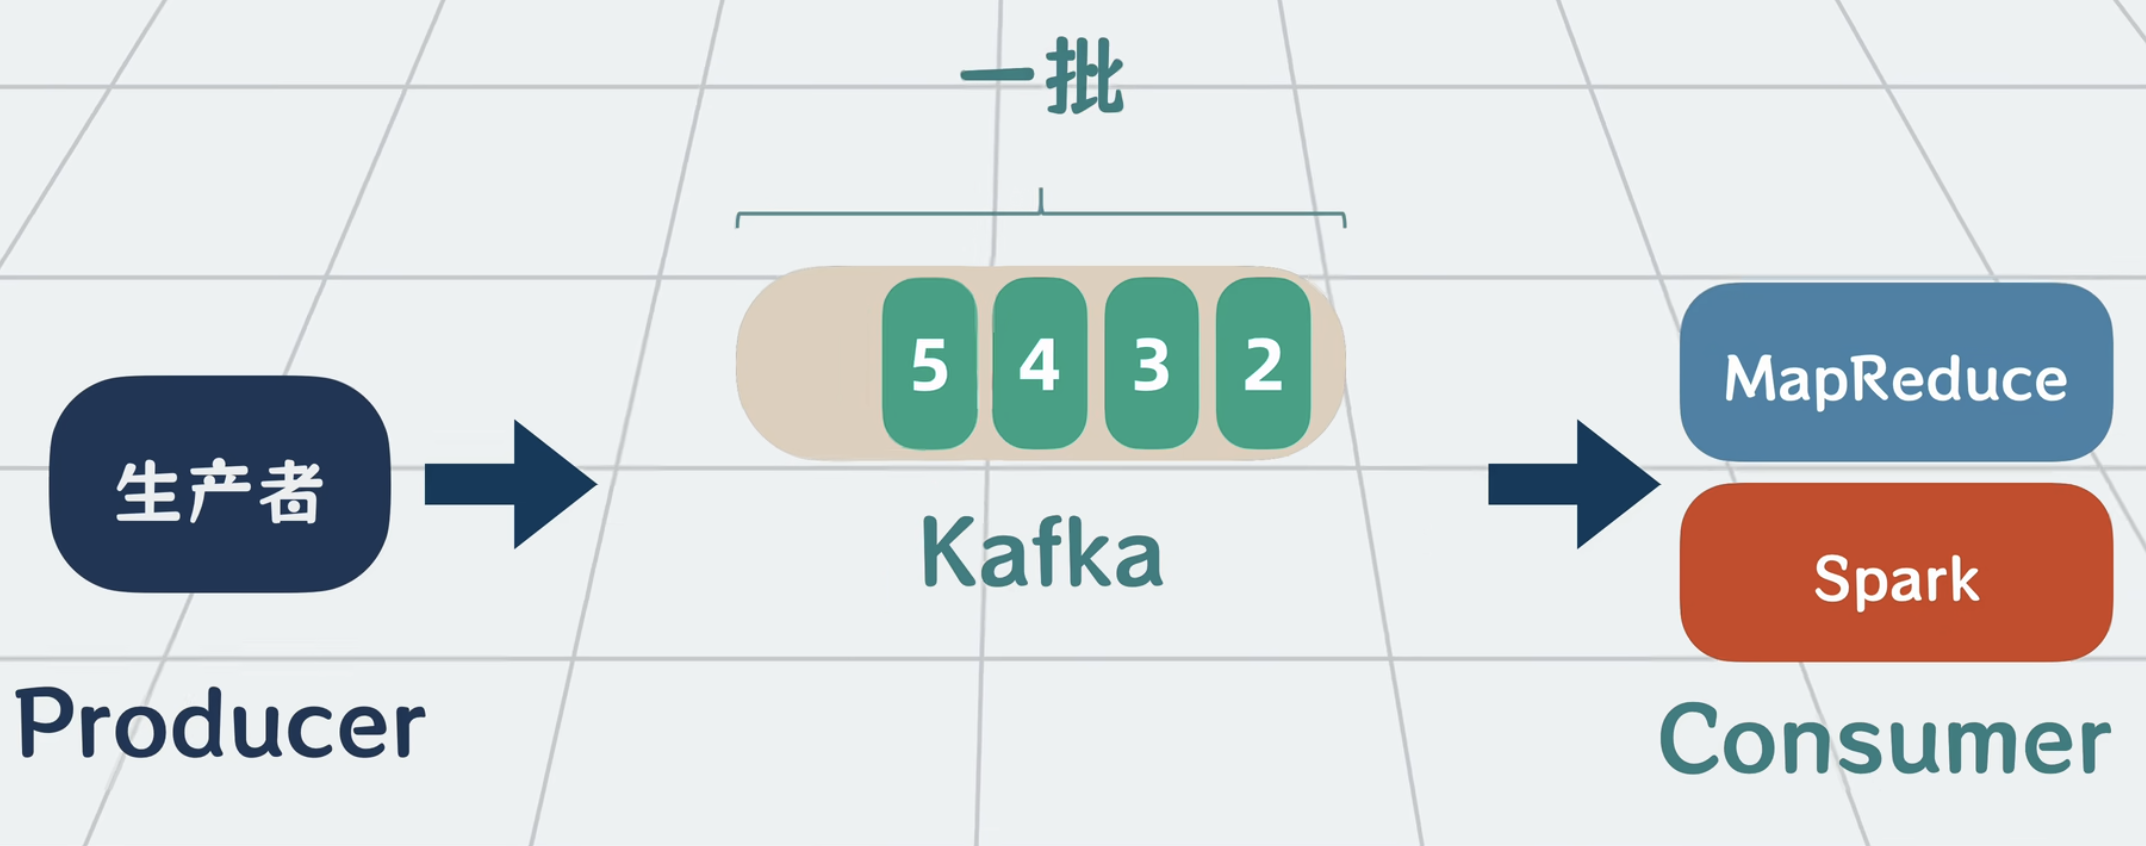
MapReduce 和 Spark 都是离线批处理,即数据是按批处理的,一条数据来了得攒够一批才会被处理
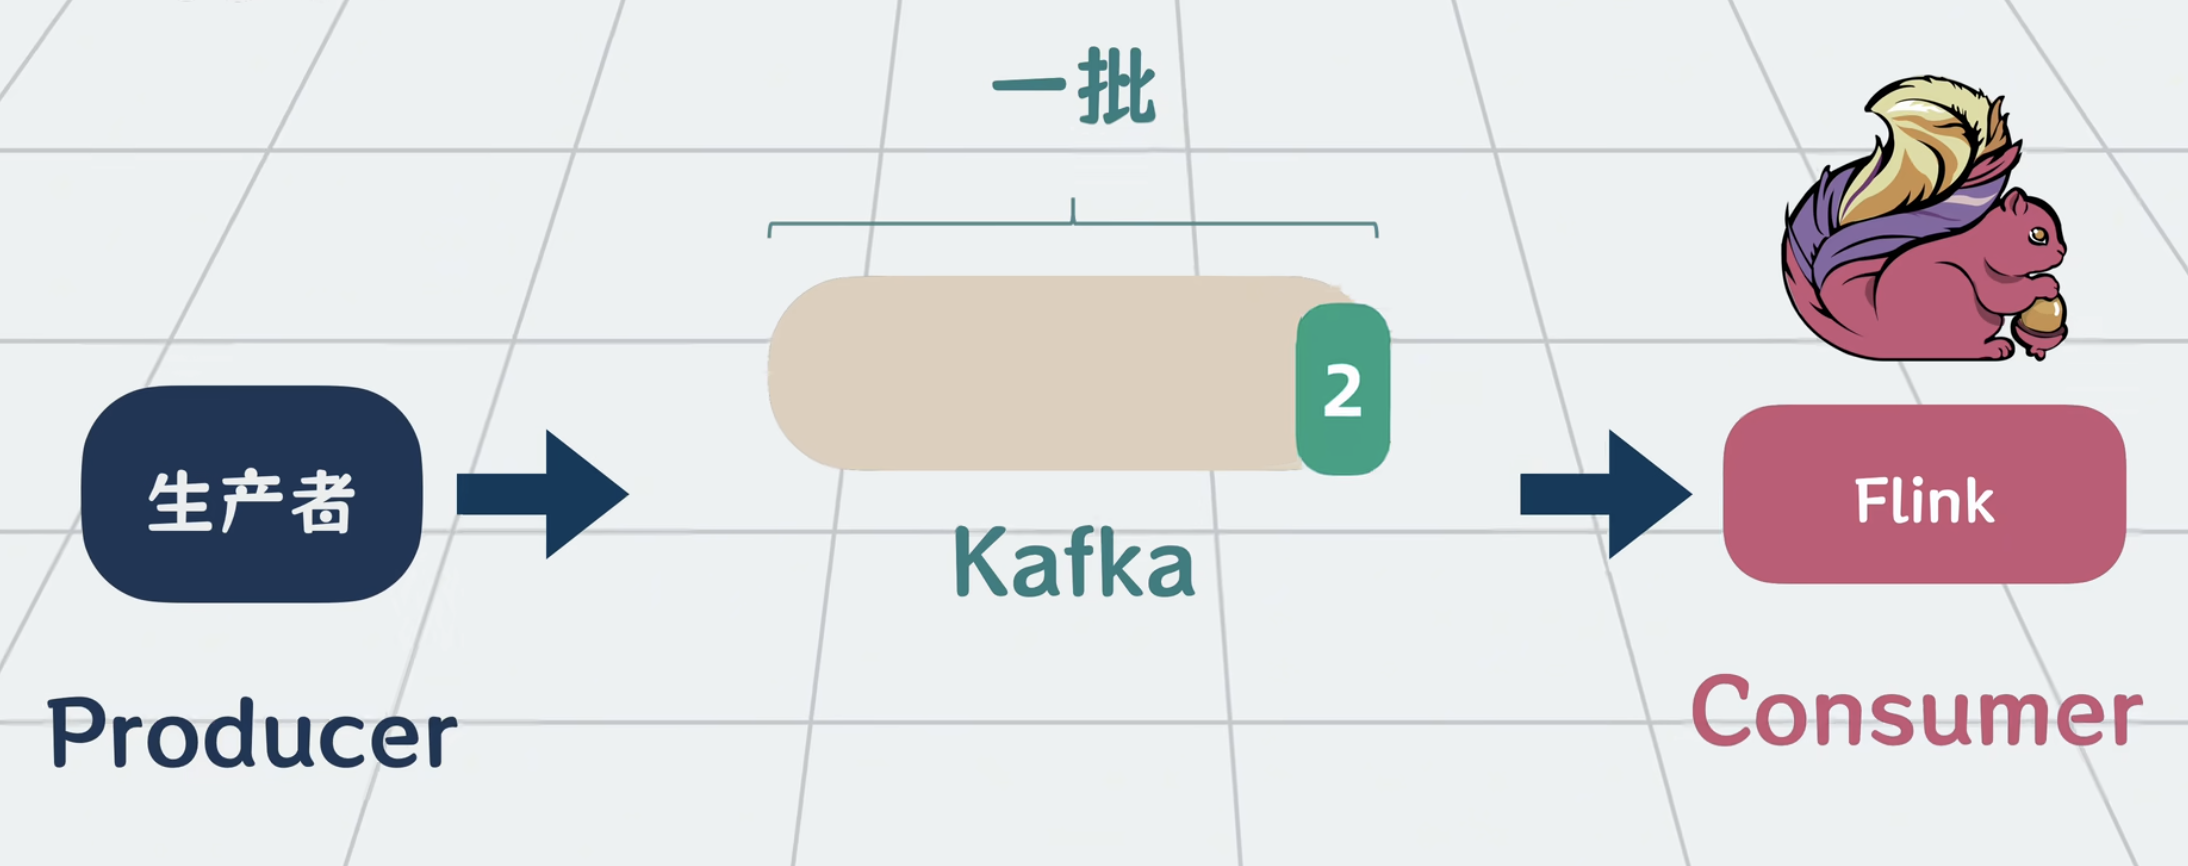
Flink 是实时在线处理,数据来一条就处理一条
Hbase 实时在线读写场景,可以通过 Hbase 实现海量数据的毫秒级查询
HDFS 和 HBase 的核心区别:
| 对比项 | HDFS | HBase |
|---|---|---|
| 本质 | 分布式文件系统 | 分布式列族数据库 |
| 主要用途 | 存大文件、批处理 | 海量数据随机读写 |
| 数据访问方式 | 文件路径 | RowKey |
| 查询特点 | 适合顺序扫描 | 适合按 Key 快速查 |
| 修改数据 | 不擅长局部修改 | 支持单行更新 |
| 删除数据 | 通常删整个文件 | 可删单条记录 |
| 使用场景 | 离线数仓、日志归档 | 用户画像、订单状态、设备数据 |
| 底层存储 | 磁盘 | 通常使用 HDFS |
HDFS(仓库)解决海量文件怎么可靠地存,而 HBase(仓库管理系统)解决海量数据怎么快速按 Key 查、改、删